最近在看 Pi Agentharness 的 V2 版本,总结下来就是看完觉得惊为天人,直接解决了我许多的困惑和疑虑,爽翻了。
Pi 的 V2 版本为工具调用增加了持久化的执行状态、恢复策略和结果暂存,以及许多的边界真的越来越清晰了,这是让我最爱的点,边界清晰才能定义职责,职责清楚了才有优化方向。
举一个例子:假设 Agent 调用邮件服务,邮件已经发出,本地进程却在保存回执前崩溃。重启后,对话停在“正在发送”,直接重试可能发出第二封邮件,仅凭聊天记录又无法确认第一封的结果。这些执行机制需要处理的,就是这类对话内容无法决定的后续行动。
这些问题可以沿着八个原则展开。它们是对这轮设计的归纳,并非 Pi 官方发布的一份“八原则宣言”;具体实现以本文核对的 v0.85.1 为界总结下来就是,架构判断则要继续接受反例检验。
原则一:事实、状态与意图三足鼎立了
Agent 在 session 中执行 “我会把附件发给 XXX”,但工具却报告缺少地址,最后模型又说“已处理”。这几句话都能保存在对话里,但不能挑一句最像最终答案的,当作发送成功的依据。
同一件事,需要分清三种信息:
| 信息 | 邮件例子 | 回答什么 |
|---|---|---|
| 意图 | 我要发送这封邮件 | 想做什么 |
| 执行状态 | 请求已发起,等待确认 | 现在走到哪一步 |
| 事实证据 | 邮件服务返回消息标识与状态 | 有什么结果可以确认 |
服务端接受邮件,也不代表收件人已经读到。**完成的含义,必须落在具体契约上。**模型决定往哪里探索,执行状态决定下一步允许做什么,结果则由有资格确认它的系统提供。
Pi 把对话条目、当前执行状态和用量记录分开保存。数据模型给它们明确的位置,但业务订单、审批和文件版本的权威仍属于各自的业务系统。保存了一句“用户已同意”,不会自动获得操作权限。
原则二:历史与当前状态承担不同责任
任务留下了“开始发送、超时、准备重试”这些记录,重启后仍要回答:下一步究竟能做什么?只保存一个 running 也不够,它没有说明是在准备参数、等待响应,还是已经拿到结果却尚未归档。
交易流水与账户余额有类似的区别。流水记录每次变化,余额用于当前判断。它们彼此关联,但承担不同责任;Agent 也需要把历史留作依据,把当前执行位置保存成可以直接判断的状态。
Pi 的恢复实现直接读取 operationMeta 和 operationState,校验它们与 Lane 的关系,再进入对应的执行路径。状态保留必要身份、输入引用和控制条件,无须让模型从聊天里猜测进度。
结果和状态还要一致地提交,否则就会出现“状态说完成,结果却不存在”。JSONL 打开时仍需扫描重建数据,旧状态在升级时也仍需兼容或迁移;直接保存当前状态并没有取消这些存储责任。存储说明
我更在意的是,同一份已保存的执行状态,不该因为换了模型或摘要提示词,就被解释成另一个位置。
原则三:任务生命周期独立于客户端连接
用户提交导出任务,关掉进度页,打算稍后回来取文件。关闭页面没有表达取消意图,如果服务器因此停止导出,一次断线就替用户作了决定。长任务的身份需要比连接活得更久。网页、手机和 CLI 可以轮流观察它,真正取消则走单独的操作。这里独立的是客户端连接;Pi 的持久化 Session 仍然承载任务数据。
Pi 把这几件事拆成 accept、drive 和 requestAbort。执行安装到 Lane 后,调用方取消等待,只结束自己的观察;其他调用者仍可以等待同一次执行。对应测试也覆盖了安装前取消不启动、安装后取消不打断执行的区别。进程重启后,还需要宿主重新驱动任务。Pi 保存恢复条件,宿主负责安排唤醒与执行所有权。调度边界必须有人承担,否则数据虽然还在,任务却不会继续。
原则四:任务除了失败之外,还有“我不道啊”
邮件服务已经发出邮件,回执却丢了。本地看到超时,也可能是请求根本没到服务端。这两种情况需要不同的处理,光靠本地记录无法判断。
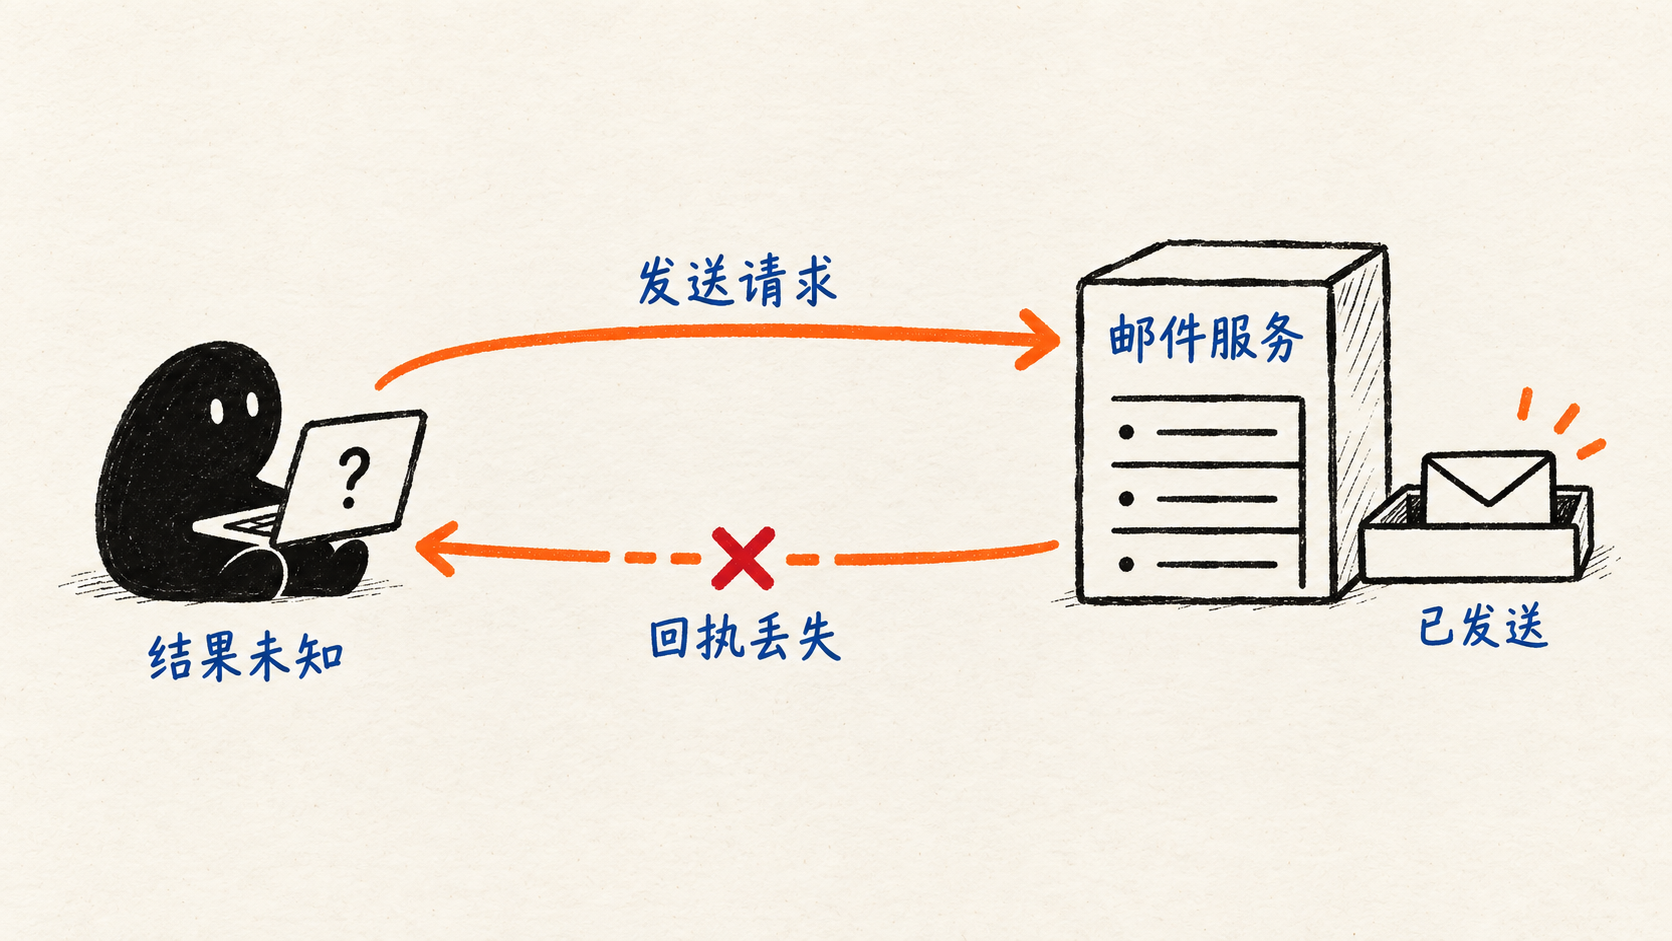
unknown 表示调用方缺少证据。把它当成失败就重试,可能重复发送;当成成功,又可能漏掉一封从未发出的邮件。调用前保存意图,能留下“尝试过”的记录,却无法消除外部成功、本地尚未记下结果的故障窗口。
Pi 的工具重放默认是 never。只有保存的策略与当前工具策略都允许 safe,恢复时才会重放;否则生成中断结果,明确外部效果未知。执行代码与测试都体现了这个约束。它只约束同一次调用的恢复。模型重新提出“再发一封”,仍可能产生新调用,所以业务接口还需要幂等身份或外部结果查询。下面的本地实验验证了这个区别:丢失回执后,换新标识重试得到两条结果,沿用原标识则保持一条。无法安全确认时,恢复可以停在等待处理。
展开实验:回执丢失后,重试会发生什么
写这篇文章时,我做了一个本地实验:用 SQLite 模拟独立服务保存发送结果,子进程在服务提交后执行 os._exit(17),刻意停在本地记录回执之前。实验没有调用真实邮件服务,也没有运行 Pi。使用 Python 3.13.4、SQLite 3.47.1,在仓库根目录运行:
1uv run --no-project python content/posts/260909/retry_demo.py
两组实验分别从空数据库开始,得到:
1new-key: local_receipt=missing; service_before=1; service_after=2
2same-key: local_receipt=missing; service_before=1; service_after=1
第一次发送的回执都不存在,模拟服务里却已经各有一条结果。重试时换一个请求标识,会再增加一条;沿用同一个标识,由服务端唯一约束去重,结果仍然只有一条。
这个实验的条件很明确:请求标识和模拟副作用在服务端同一事务里提交。如果只在调用方建一张去重表,再调用一个不支持去重的邮件 API,那个故障窗口仍然存在。
现实接口也有自己的边界。Stripe 的幂等请求会保存同一幂等键对应的请求结果,并检查参数是否一致;键有保留期限,过期清理后复用可能成为新请求。不能只给参数起名 idempotency_key,就认为任何工具都获得了相同保证。
展开恢复流程:重试、查询或等待处理
flowchart TD
    P[固定参数与调用标识] --> I[本地提交执行意图]
    I --> E[调用外部服务]
    E -->|取得完整结果| C[本地原子提交
结果与下一状态]
    E -->|回执丢失或进程中断| U[恢复时结果未知]
    U --> Q{工具契约支持什么}
    Q -->|可安全重放| R[复用原调用身份重试]
    R --> E
    Q -->|可查询| V[核对外部结果]
    V -->|取得确认| C
    V -->|仍未确认| H[保留未知并等待处理]
    Q -->|缺乏安全恢复手段| H
查询和人工处理是通用设计选择,Pi 不会自动替任意工具实现。safe 也需要工具实现者兑现,运行时不能仅凭标记证明外部副作用可安全重复。
原则五:完成、保存与展示可以有不同顺序
Agent 同时准备附件 A、查询联系人 B。A 很慢,B 已经完成。如果为了按 A、B 的顺序展示,把 B 留在内存里等 A,进程一崩,已经拿到的结果也丢了。
Pi 用 outcome_ready 把保存与归档分开:B 的完整结果先持久化,等 A 就绪后,再按调用顺序写入对话树。工具持久化设计
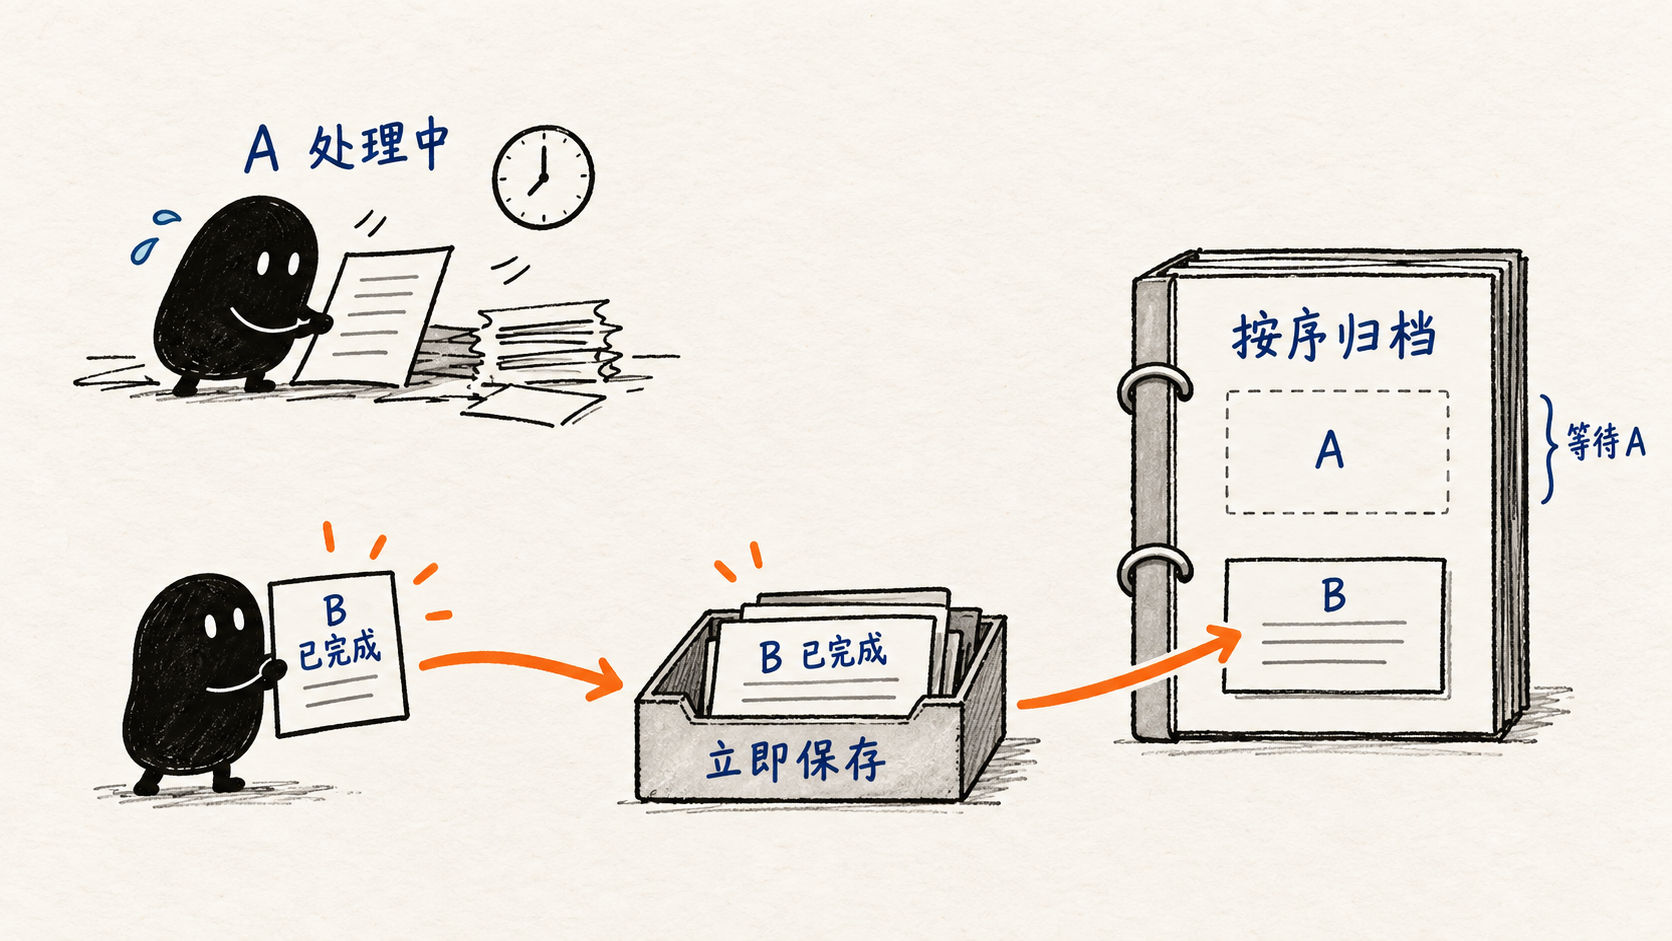
发起顺序来自调用安排,完成顺序取决于实际耗时,展示顺序服务于阅读或协议要求。保存已完成结果,不必被展示顺序拖住。恢复时,已经持久化的 B 只需继续归档,无须重新执行。
多出的暂存状态确实增加了一次存储转换,但它接住了一个具体的故障窗口。outcome_ready 也可能装着失败结果,它只说明结果已经确定,不保证业务成功,更不负责解决两个工具同时修改同一对象的冲突。
原则六:信息分支与计算资源也被独立建模了
让 Agent 为一篇文章探索三个开头,写完后只选 B 继续。A、C 值得保留,但没必要让三个执行进程一直运行。保存一个方向与分配一份计算资源,是两件事。
Pi 的 Branch 保存命名的内容路径;AgentLane 在其上增加模型配置、队列和执行状态。Lane 也不等同于一个操作系统进程,具体资源由宿主安排。Branch 与 AgentLane 的定义
flowchart TD
    H[共享的前序材料] --> A[候选 A]
    H --> B[候选 B]
    H --> C[候选 C]
    B --> B2[沿 B 增加新内容]
    W[按需分配的执行资源] -. 推进 .-> B2
图里 A、C 继续保留,只有 B 获得了后续计算。这与 Git 分支有相似之处:创建分支不会自动启动一台机器。上层因此可以决定哪些方向并行探索,哪些串行处理,哪些暂时归档。
共享历史只解决内容组织,不会自动完成 Agent 协作、合并文件冲突,也不意味着模型处理上下文不再消耗 token。
原则七:流式输出是观察,提交才确立记录
工具显示进度 90%,模型写着“附件已生成,邮件正在发送”,下一秒连接断了。重新打开页面,这些文字可以继续展示,但邮件是否发出,仍要看实际回执。
第一条原则区分信息的性质,这里区分输出的阶段:部分内容、完整结果和已提交记录。流中半个工具调用可能连参数都没凑齐,不能据此执行;一段完整的模型回答,也不能单独证明外部动作成功。
Pi 可以保存部分输出供恢复展示,工具进度则始终属于辅助观察数据。输出生命周期把它与最终结果分开。崩溃后只能恢复最后已持久化的片段,较新的内存内容可能丢失,也不承诺接回原来的模型生成连接。流恢复边界因此,界面应让用户分得清:哪些是仍在产生的内容,哪些已经确认,哪些因中断而未知。即使每个 token 都存下来了,最后一句“好了”也不能替业务任务作出成功判定。
原则八:可强制保证的约束,交给结构和机制
编辑工具需要文件路径、起始行和替换内容。提示词可以解释用途,Schema则能直接检查行号是否为整数、字段是否齐全。能机械检查的条件,不必每次都寄希望于模型记得。
Pi 在工具执行前调用 validateToolArguments;如果 before_tool 替换了参数,还会重新校验。实现检查的是最终要执行的输入,避免参数在校验后又被改坏。
但结构合法只是一层。对同一笔编辑,各种条件有不同的负责人:
| 同一笔编辑请求 | 需要回答的问题 | 合适的检查位置 |
|---|---|---|
| 参数结构 | 行号是不是整数,字段是否齐全 | Schema 与入口校验 |
| 访问权限 | 当前身份能不能修改这个文件 | 文件或业务访问边界 |
| 版本条件 | 读取之后,原内容是否已被别人改动 | 条件写入或事务 |
| 用户意图 | 这次替换是否符合用户要求 | Agent 判断与必要的人类确认 |
| 重复执行 | 恢复后再提交会产生什么效果 | 工具与业务幂等契约 |
比如“基于 v7 的修改不得静默覆盖 v8”,需要在写入时通过事务或条件更新保证。提前查一次版本,再无条件覆盖,仍然会留下并发窗口。至于新文字是否更好,仍需模型判断或人来选择。
我理解这条原则的价值,是把能够反复检查的要求从“每次都要记得”变成“每次都绕不过去”。模型负责理解目标和作出取舍,执行边界落实稳定、可验证的限制。
Pi 的核心哲思:选择可以开放,行动需要边界
这些原则放在一起,我才觉得 Pi 的“极简”有了更具体的含义。它允许模型在开放的问题空间里选择动作,同时要求执行系统明确保存身份、位置、结果和边界。两部分面对的是不同类型的困难。
模型擅长在目标不完全明确、路径无法穷举的时候寻找方案。比如准备一份研究材料,可以先读文档,也可以先运行实验;发现最初假设不成立,还可以换方向。把所有有价值的探索都预先编成固定流程,可能会限制模型利用新信息的能力。
执行系统承担的要求则更稳定:不能把未确认的动作说成成功,不能因为观察者离开就随意丢掉任务,不能让已持久化的结果在恢复时被当作从未发生。这些要求不需要随着模型每一次改变策略而改变。
**让智能负责选择,让系统负责边界。**这是我从这轮 Pi 设计中归纳出的核心哲思。它不保证模型永远选对,也不宣称程序能消除现实中的所有不确定性;它要求自由探索始终发生在可识别、可检查、可恢复的行动条件之内。
下面的职责分配是架构解释,不是一张 Pi 包依赖图。运行时管理执行与恢复,工具及业务系统检查实际修改是否允许;结果和失败证据返回模型,帮助它选择下一步。
flowchart TD
    U[目标与偏好] --> M[模型
理解、探索、选择动作]
    M --> R[运行时
状态、持久化、恢复策略]
    R --> T[工具与业务边界
权限、版本、幂等约束]
    T --> E[外部系统]
    E --> F[结果与可核对证据]
    F --> R
    R -->|反馈| M
    R -. 过程与已提交结果 .-> V[观察界面]
对通用运行时来说,克制还意味着承认自己不知道业务规则。它可以知道某笔调用尚未确认,却未必知道如何查询邮件服务;可以保存完整结果,却未必知道某份报告是否足够好。为了显得“全自动”而替业务猜测这些条件,会扩大框架的权力,却削弱结果的可信度。
这也改变了我对自主性的理解。自主程度不能只按“不问用户、连续调用多少次工具”衡量。面对未知结果能否换一条有证据的查询路径,在无法确认时能否停止,都是行动能力的一部分。系统可以在安全范围内持续工作,正因为有些边界不必交给模型临场决定。
回到邮件例子,模型可以选择先写正文还是先整理附件,可以为失败寻找替代方案。但它没有权力把一个 unknown 改写成“应该没发出去”,再用新的身份偷偷尝试一次。新的行动需要新的依据。
极简要容纳问题本身的复杂度
网络中断、进程崩溃、并发完成和用户离开,这些复杂性在框架出现之前就存在。删除相应状态,不会删除这些情形,只会让使用者在某个角落重新处理它们。
outcome_ready 是一个很好的例子。它增加了概念和存储步骤,但每一项都对应一个明确故障窗口。相反,如果只是为了一个未来可能出现的后端,就提前引入一套通用调度语言,当前使用者需要理解的东西变多,却未必减少任何真实风险。
这种区分不能靠代码行数裁决。一个几十行的 Agent loop 可以非常适合一次性、可重跑的工作;如果它要承担跨进程、带副作用的长任务,恢复身份与结果保存就成为需求本身。为后者补上状态机,并不构成对前者极简价值的否定,责任已经变了。
Pi 的实现规范明确采用直接的异步执行过程,按保存的状态分派恢复路径,不再额外叠加一层图解释器或动作调度器。Drive 的执行规则
它当然仍然有状态机。工具可能处于计划、等待外部效果、完整结果待归档等阶段,取消也有自己的控制条件。可贵之处在于这些状态对应实际执行语义,可以沿着函数和提交顺序追踪,而不必先理解另一种编程语言。
写入所有权也体现了这种取舍。这个版本要求宿主为同一个可写 Session 安排唯一所有者,存储后端不会代替宿主强制这一条生命周期规则。明确单一所有者可以减少协调复杂度,代价是宿主必须兑现承诺;不能把它误读成支持任意多个进程同时写入。所有权前提
所以极简也包含非目标。没有平台调度器,就需要说明谁来唤醒;没有通用 exactly-once,就需要说明何时不能重放;没有业务权限模型,就需要把权限检查放到宿主或工具边界。清楚地结束自己的职责,比留下一个看似包办一切、实际保证含混的接口更有用。
这些约束也不天然要求一个庞大的框架。一个固定流程可能只需要一张任务表、一项条件写入和明确的幂等接口。只有当分支、并行工具、流式观察与恢复确实进入需求时,相应抽象才需要出现。原则决定必须保证什么,具体规模决定值得实现多少。
本文核对的是 Pi v0.85.1 固定版本的源码、设计文档与测试定义,并未运行其完整测试套件。它能支持对上述机制的讨论,不能证明所有恢复路径已通过生产验证,也不能推断普通 CLI 已全面迁入这套 Harness。将实现、设计目标和验证程度分别讲清楚,本身也属于对事实边界的尊重。
我会用这些边界去判断下一轮 Agent 架构变化。多一个概念,应该能指出它接住了哪种真实失败;少一层抽象,应该仍能说明原来的责任由谁承担。最终可以落到一个具体检查:在外部动作已经发生、本地结果尚未保存的位置让进程消失,系统重新出现后,有没有资格执行它的下一步。