最近研究全链路自进化的视频转绘项目,我想做的事情:从原视频出发,理解剧情和人物,完成转绘与视频生成,再让系统根据结果发现问题、尝试改进。理想中,每跑一轮,下一轮应该更接近我想要的成片,但是这个过程中一个大的难点就是如何做审核?如何评估好坏,如果需要灌注人为的经验和知识进去该怎么办?流程跑完了,审核通过了,Agent 保留了一次修改,这些都容易留下记录。至于视频究竟有没有变好,我应不应该把自己的经验和注意力在这个环节灌入进去,真是该死这是最难的事情!
这让我重新看待 Richard Sutton 的 《The Bitter Lesson》。我原本想讨论的是通用方法如何利用更多算力;放到自己的项目里,还得先弄清楚:新增的计算,究竟在推动什么。
系统在改进,先得确认改进的是哪件事
这次项目里有一条 autoresearch 循环,Agent 修改方法、运行评估,再决定是否保留修改。我希望它帮助整条视频生产链变好,而不只是把某个环节的分数推高。
有一轮本来要跑独立验证,检查方法换一批样本后还管不管用。结果评测入口没切过去,又跑了一遍旧开发集:58 次请求,57 次被接受。独立集一次都没跑。与此同时,Agent 的 keep 只表示保留了代码,不能说明这一轮已经通过质量验收。项目记录摘记
57/58 这个数还在,但它只能说明旧样本通过了当前检查。换一部视频还能不能用,成片有没有更忠实,都没测到。
连“通过率”本身也需要拆开。结构合法、审核可靠、修复有效、成片质量提高,是几件有关联但不能互相代替的事。项目后来明确把这些维度分开记录:由 accepted/total 算出的 first-pass 指标只作为结构辅助信号,不能直接充当生成质量目标。
如果我把一个不准确的目标交给系统,让它多跑一百轮,它也许会更擅长改善那个数字。可我仍然不知道它离想要的视频近了多少。
审核说要修,任务板还在往下走
转绘首先需要理解原片。这个环节提取错了,后面的人物设计、镜头组织和视频生成就可能沿着错误继续往前走。局部生成得再漂亮,也补不回一开始误解的剧情。
9 月 7 日凌晨,另一次源内容审核找出了三处问题。记录里都能定位到原片。
原片约 32.5 秒的字幕写的是“送掉”,结构化 Story 里变成了“卖掉”。另一处,银幕中的女性在提问,提取结果却把对应动作绑定到了男性。还有一段从客厅切入银幕画面、再返回客厅的视觉插入,在提取结果里只剩下一条画外台词。
这三处能用画面或字幕核对,审核没有白做。但当时还没核对实际音频,也不知道它漏掉了多少问题、换一部剧是否还有效。
我希望它拿着这三处反馈去修,然后再看一遍原片,检查有没有修对。
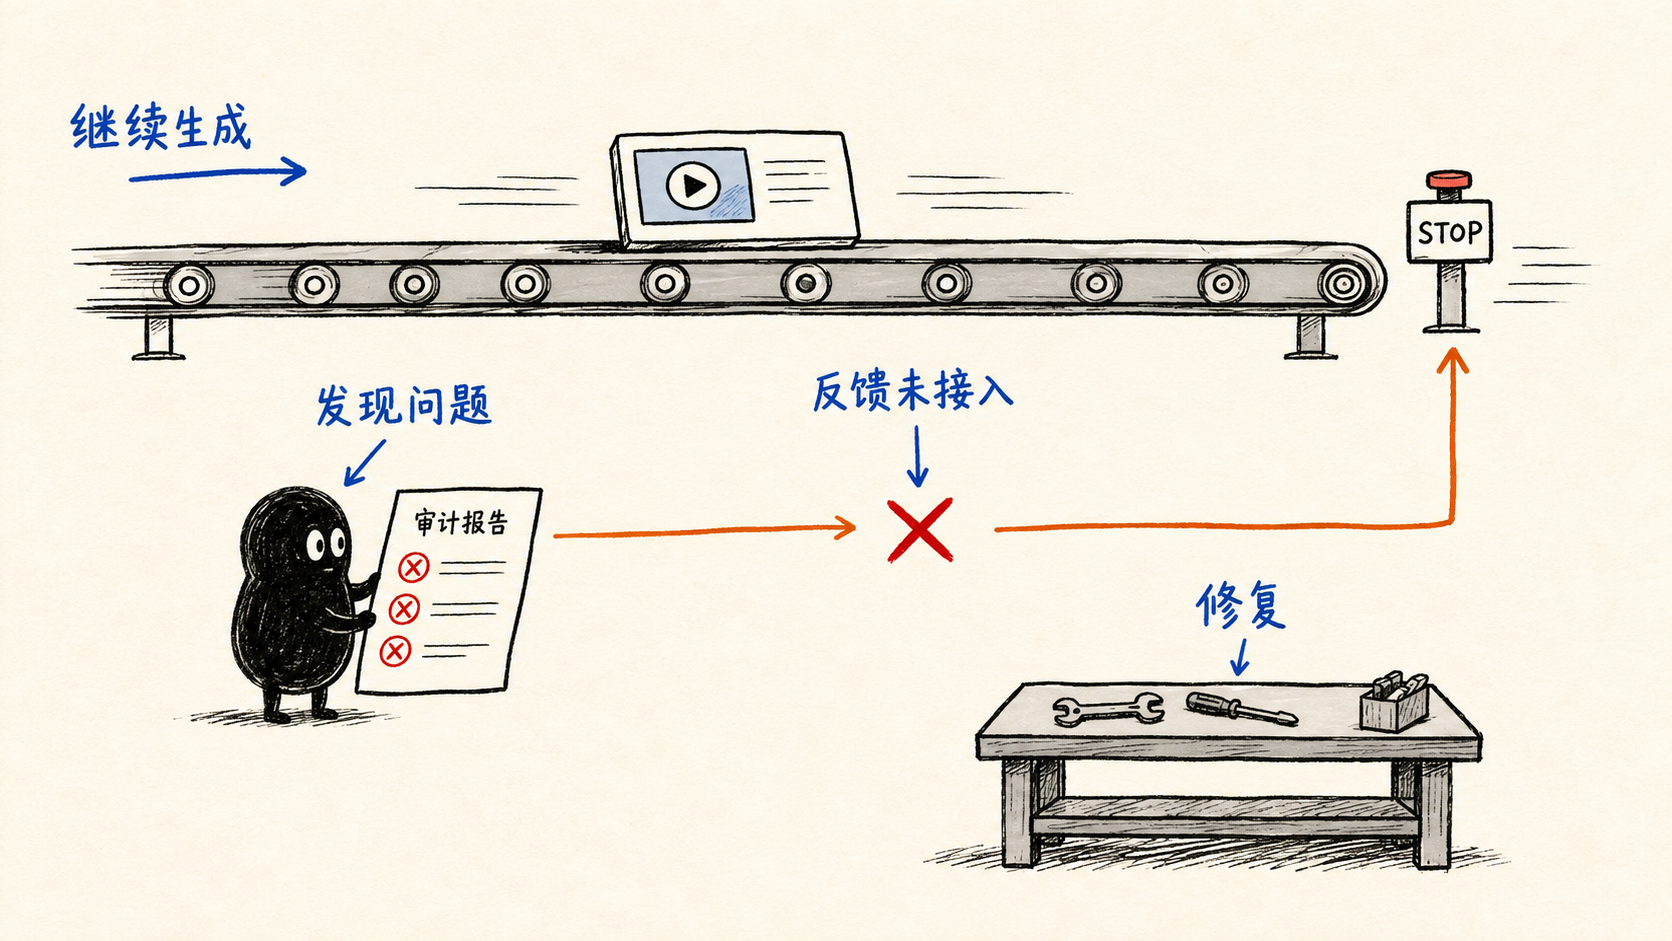
实际查下来,审核已经判了 repair,任务板上却只有 story.normalize。下游根本没用这次审核结果决定能不能继续。试着在内存里补上修复预算,规范化和修复又一起被放了出来。审核加上了,后面该停还是该修,还没接好。
flowchart TD
    A[提取源内容] --> B[原片对照审核]
    B --> C[发现差异
判定 repair]
    A --> D[继续规范化]
    C -. 未参与准入 .-> D
    C -. 期待进入 .-> R[修复并复审]
    style C fill:#fff3df,stroke:#cc8a25
    style D fill:#ffe8e8,stroke:#b85252
图里的虚线就是没接上的地方。
到这一步,再让审核模型多想一会儿也解决不了问题。它已经指出了哪里不对,多写几条意见,后面的任务还是照旧跑。
这轮能记下的成绩,就是找到了三处问题。成片有没有变好,还没测。
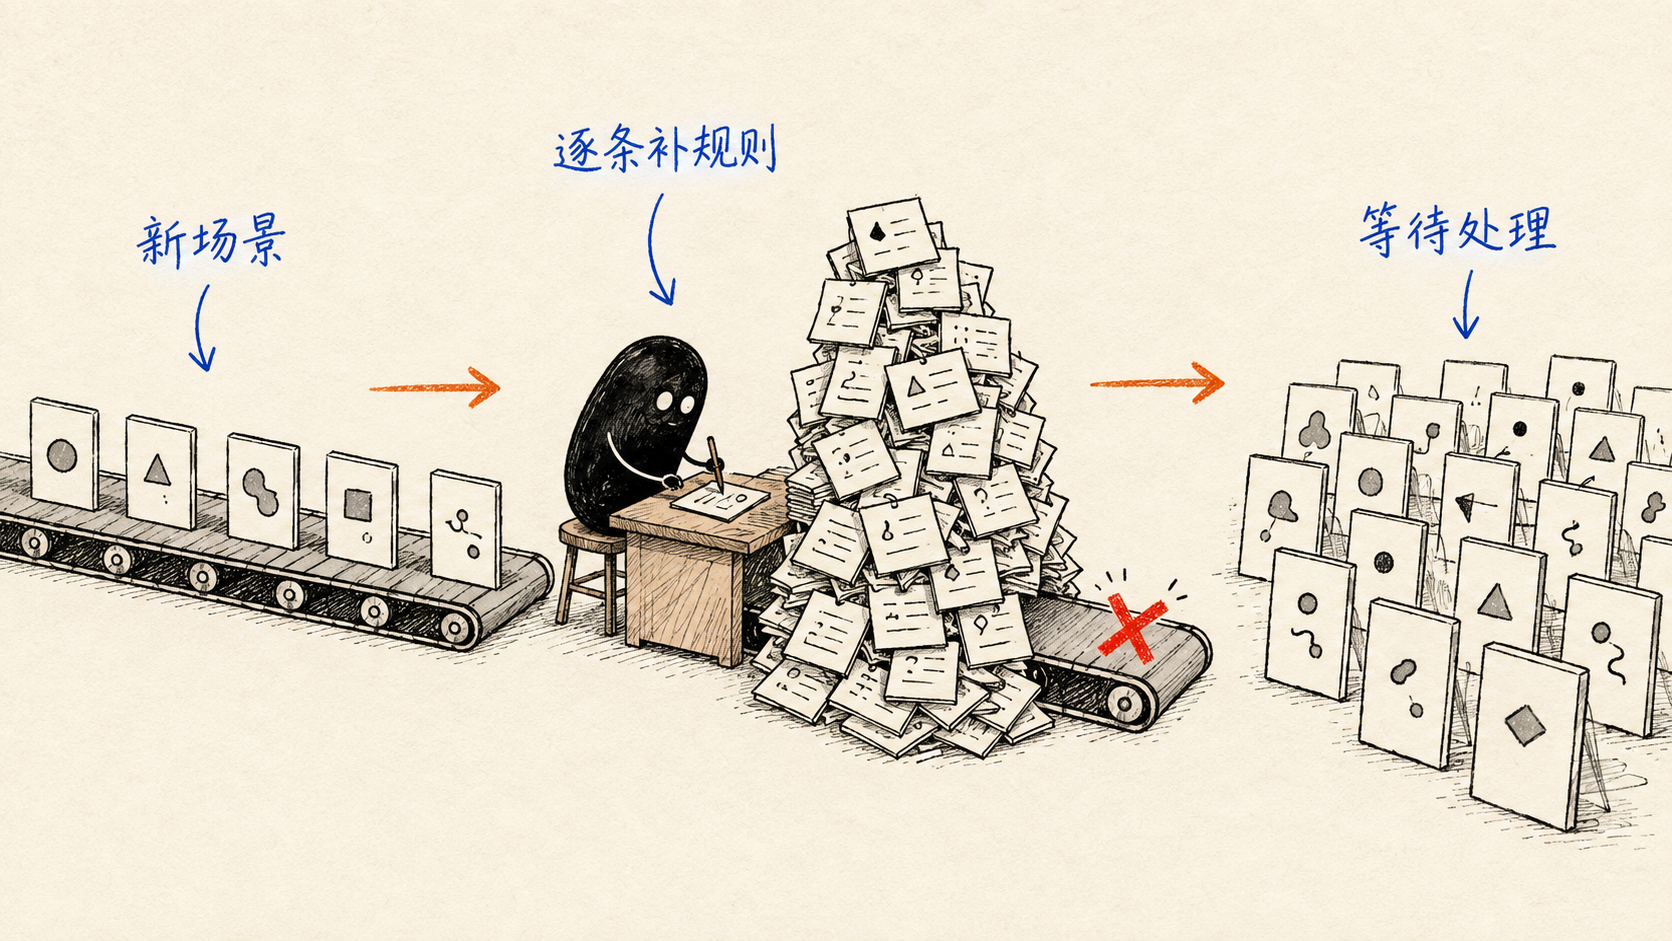
很容易又回到逐个补答案
有了这三个具体问题,最直接的做法当然是把对应文字、人物绑定和插入镜头改掉。对交付一个样本来说,这可能有必要;但如果研究目标是全链路自进化,手改完这一段,还没有回答下一个视频怎么办。
如果每次最后都要我亲自改台词、重新绑人物、补镜头,那我做的还是这一部剧的修复。下一部剧再出错,仍然得等我来。
Sutton 在原文里回顾国际象棋、围棋、语音识别和计算机视觉,指出通用搜索与学习在长期竞争中的优势。他把比较放在计算成本持续下降的背景下:今天靠领域知识取得的优势,未必能延续到未来更大的计算预算里。
放到这个项目里,再给系统一百倍计算,它能独立多处理一些没有见过的问题,还是只能更快地重复已有流程,然后等我来解释失败?不过,我也不能因此把约束和流程全删了。
AlphaZero仍然有游戏规则和胜负定义,具体怎样取得优势才交给自我对弈、学习与搜索。我的视频项目同样需要明确目标:原片内容需要保留到什么程度,哪些变化属于允许的转绘,什么证据足以说明修复有效。这些要求不能靠模型自由猜测。
所以我愿意明确写下“修复后的内容必须再次对照原片”,也愿意保留失败时的停止出口。它们给探索定义了条件。至于某一秒是谁说话、某个镜头该怎样表达,则应该由有原始证据的求解过程来处理。
自进化需要让反馈改变下一次行动
对这套 RSI 视频生成系统,我希望下一轮能说清楚:发现了什么问题,改了哪里,重生成的结果有没有好一些。
flowchart TD
    S[原片与转绘目标] --> G[生成候选产物]
    G --> V[对照原片验证]
    V --> D{证据支持什么}
    D -->|存在差异| H[提出改进假设]
    H --> R[修改方法并再生成]
    R --> V
    D -->|当前样本改善| T[冻结方法
验证新样本]
    T --> K[决定是否保留]
    D -->|不确定或预算耗尽| X[保留证据并停止]
图里还有没跑通的部分。即便当前样本修好了,我也得冻结方法,再拿新样本试一次。否则,针对这部剧写进去的答案,很容易藏在 prompt 里,被当成方法的进步。
Scaling Laws展示了语言模型训练损失与规模、数据和计算之间可测量的关系;o1 的研究说明则报告了增加训练与测试时计算带来的评测改善。这些工作让我对计算能够推动能力增长保持期待。但具体到我的系统,仍要把“更多计算”接到有效探索和可靠验证上。
自然而然的想到,下一笔预算可以用来检查原片中被忽略的片段,检验一次修复假设,或者在新样本上挑战现有方法。它不该只换来更多写着“通过”的报告。**遇到一个新错误之后,下次能不能少让我处理一件事?**整个实验过程下来我更想知道,下次再把台词提取错了,系统能不能自己对照原片发现、修好,并且不把原本正确的内容改坏。多跑几轮应该帮我做到这个。
我的 RSI 价值观逐渐的丰富起来了…