今天讲解一下最近火热的 Jev 模型,17 号过的 waitlist,测试了一下效果,下面讲解一下。
举一个电商场景例子:客服路由只需要选一个队列,工具调用只需要选一个动作,审核分流只需要决定放行还是复核。这些任务的输出空间很小,却经常走一条很长的路径:模型生成一段文字,程序解析 JSON,最后取出一个枚举值。如果最后只消费一个选择,语言生成是否仍然是合适的计算方式?
Jev 把这个问题放到了台前:输入状态和预先定义的问题,直接返回程序可以消费的决策及概率。开源项目 jevlike 则提供了一个足够简单的实现,方便观察“上下文加候选选项”怎样变成一组分数。
两者需要分开看。Jev 是商业模型,jevlike 是输入输出形态相近的独立研究项目。 TypeSafe 的发布说明介绍了并行采样和 RLCD 训练方法,但没有给出足以复现模型的架构与训练细节;不能用 jevlike 的代码解释 Jev 内部究竟如何工作。TypeSafe 发布说明、jevlike 仓库
从生成答案到给选项评分
沿用客服场景。用户说“订单扣款了,但商品没收到”,系统提供退款、售前、技术支持、物流四个队列。此处的任务是分流,选择退款队列并不代表批准退款。
自回归模型逐步预测下一个 token,后面的输出依赖前面的输出。让它返回类别和解释,就需要完成相应的生成过程。如果系统真正需要的是四个候选队列的概率,也可以直接建模:
$$ P(a_i \mid x, A) $$
这里的 $x$ 是上下文,$A$ 是本次请求提供的候选集合。候选集合也是条件的一部分:在“退款、物流”之间比较,与在“退款、物流、人工澄清”之间比较,分布的含义不同。
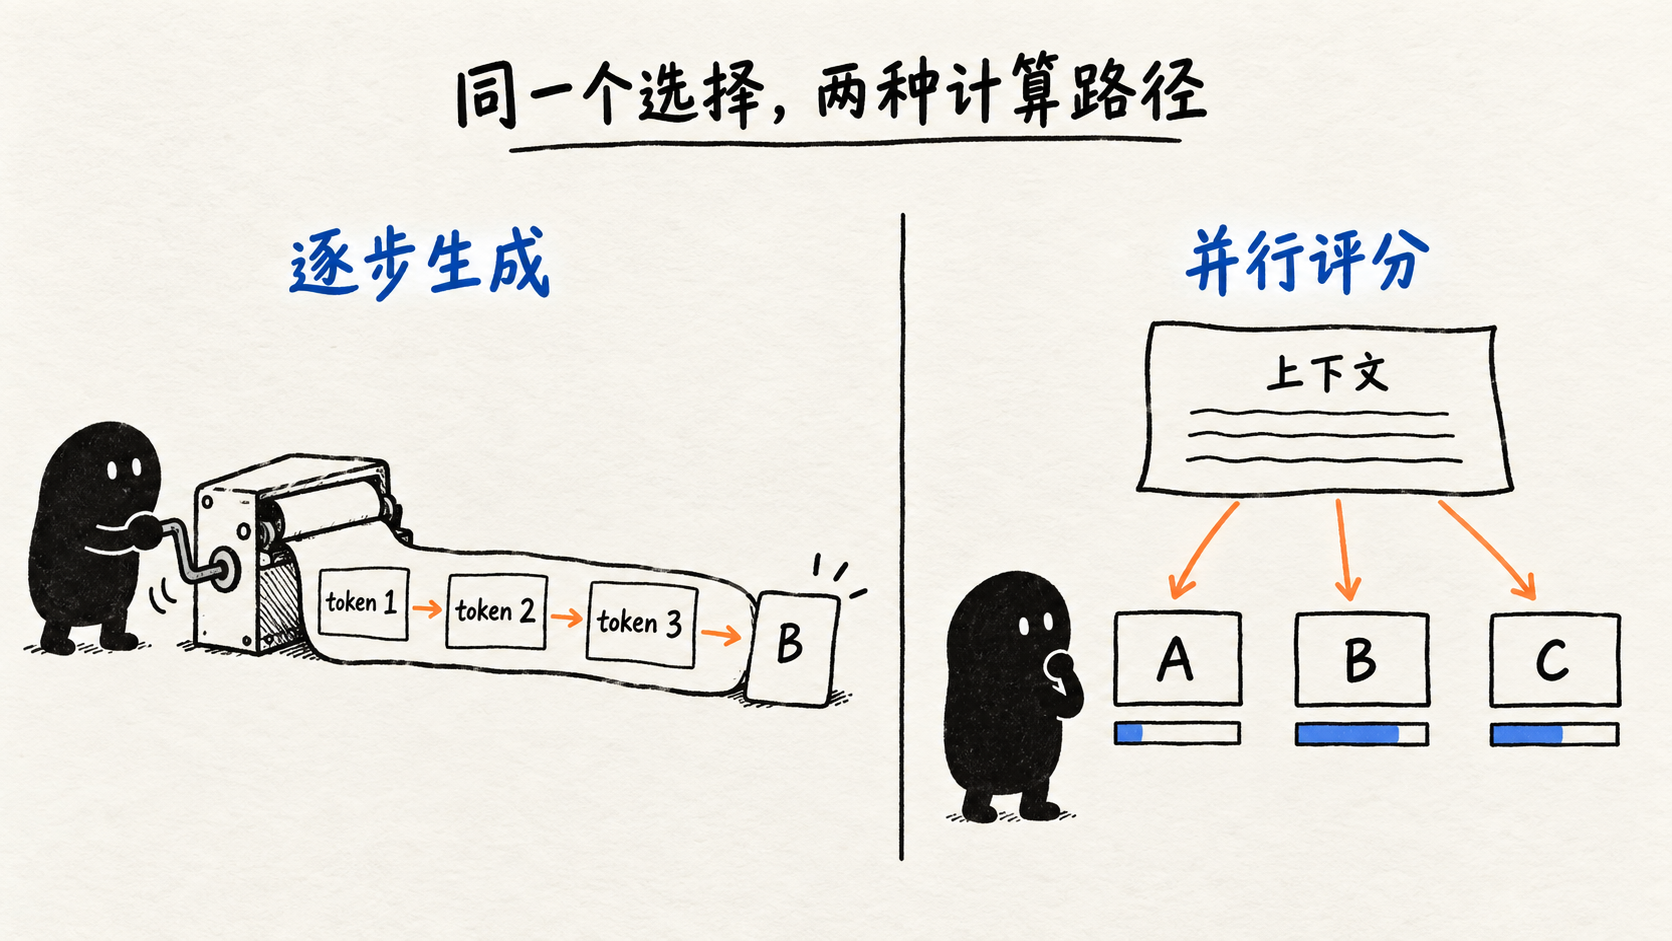
这类任务并不新,分类器和排序模型一直在解决类似问题。值得关注的是接口的选择:当调用方需要的就是决策,可以把决策本身作为模型输出,而不必总是借道一段自然语言。
Jev 的接口也不止单选。官方文档列出 Choice、Score 和 Noul 三类问题,分别用于选项选择、按量表评分和命题判断,并建议把复杂判断拆成独立问题,再由代码组合结果。下面只讨论最容易看清机制的候选选项评分。TypeSafe 文档
jevlike:每个选项都去读取上下文
jevlike 的核心是 AttentionHead。阅读本文核对的源码版本,可以把它的计算分成三个动作。
先编码上下文和选项。上下文保留 token 级表示,每个选项则汇总成一个向量。评分头分别对两者做 LayerNorm,然后将选项投影为 Query,将上下文投影为 Key 和 Value。
接着,每个选项用自己的 Query 对上下文做注意力加权。用 $o_i$ 表示归一化后的第 $i$ 个选项向量,$C$ 表示归一化后的上下文,$r$ 表示投影宽度:
$$ q_i = W_q o_i, \qquad K = CW_k, \qquad V = CW_v $$
$$ h_i = \operatorname{softmax}\left(\frac{q_i K^T}{\sqrt r}\right)V $$
这里的 softmax 沿上下文 token 维度计算,padding 位置会被屏蔽。不同选项得到不同的上下文摘要 $h_i$。可以把它理解成:每个选项都在读取与自己相关的信息。不过,注意力权重只是计算过程,不应直接当成可审计的业务证据。
最后,计算选项向量与对应上下文摘要的点积,得到一个 logit,再沿选项维度归一化:
$$ s_i = \frac{q_i \cdot h_i}{\sqrt r}, \qquad p_i = \frac{\exp(s_i)}{\sum_{j\in A}\exp(s_j)} $$
两个 softmax 做的是不同的事:前一个决定如何汇总上下文,后一个比较候选选项。源码里的评分头返回 logits,最后的选项 softmax 在预测入口完成。
这也解释了它与固定类别分类头的区别。固定分类头通常把类别对应到固定输出位置;jevlike 把选项文本作为输入,通过共享评分函数处理不同菜单。增加一个选项不需要扩大分类头,但这只是结构上的支持,不保证模型能正确理解任何新选项。
省掉了生成,编码仍然要付成本
并行评分缩短的是输出端的串行依赖。若以 $T$ 表示输出 token 数,可以粗略比较两条路径:
$$ \text{生成路径} \approx \text{输入处理} + T \times \text{解码步骤} $$
$$ \text{评分路径} \approx \text{上下文与选项编码} + \text{候选评分} $$
这是计算结构的示意,不是延迟预测公式。输入长度、批量大小、硬件和服务实现都会改变实际结果。
jevlike 在评分头里将所有候选一起计算。Query 的形状是 [B, N, r],Key 的形状是 [B, L, r],注意力分数的形状是 [B, N, L]。增加候选数会增加计算量和中间张量内存,但不需要先生成选项 A 的文本,再等待选项 B。
不过,“一次评分”容易让人误以为只做一次极便宜的网络调用。FrozenTransformerScorer 实际上先调用编码器处理上下文,再把选项展开成一个 batch,第二次调用编码器处理选项,最后进入评分头。编码器被冻结,只意味着不更新其参数,并没有消除推理成本。
同样,“只训练一个小头”只适用于它的预训练编码器模式。默认的 TinyScorer 还会训练字节嵌入和位置嵌入。两条路径都使用交叉熵学习正确选项,但能力基础和成本并不相同。模型实现、训练入口
因此,速度数字必须连同比较条件一起读。jevlike README 报告的约 100 倍加速,比较的是八个选项的一次评分,与一个被要求生成 400 个 token 的小型解码器。这不是它与 Jev 的性能对比,也没有证明它比只输出一个标签的模型快 100 倍。实验口径
TypeSafe 则在发布说明中报告了约 70~500 ms 的服务端到端响应时间,以及特定任务上的 40~200 倍延迟优势。它的 workflow 评估使用其他模型的平均预测作为参考,不能直接读成相对人工真值的准确率;官方也披露了评估地域、输入及比较方式等限制。本文没有复跑这些性能实验。官方结果与限定条件
真正与业务相关的比较,应让模型解决同一个任务,返回同样的信息,并在相近质量下测端到端延迟。只需要类别,和同时需要每个选项的概率,本来就是不同的输出合同。
类型正确、判断正确、概率可信,是三件事
给定合法选项 A、B、C,一个只返回候选索引的模型不会凭空写出 D。这个限制对软件很有用,但它仍然可以在正确答案为 C 时选中 B。
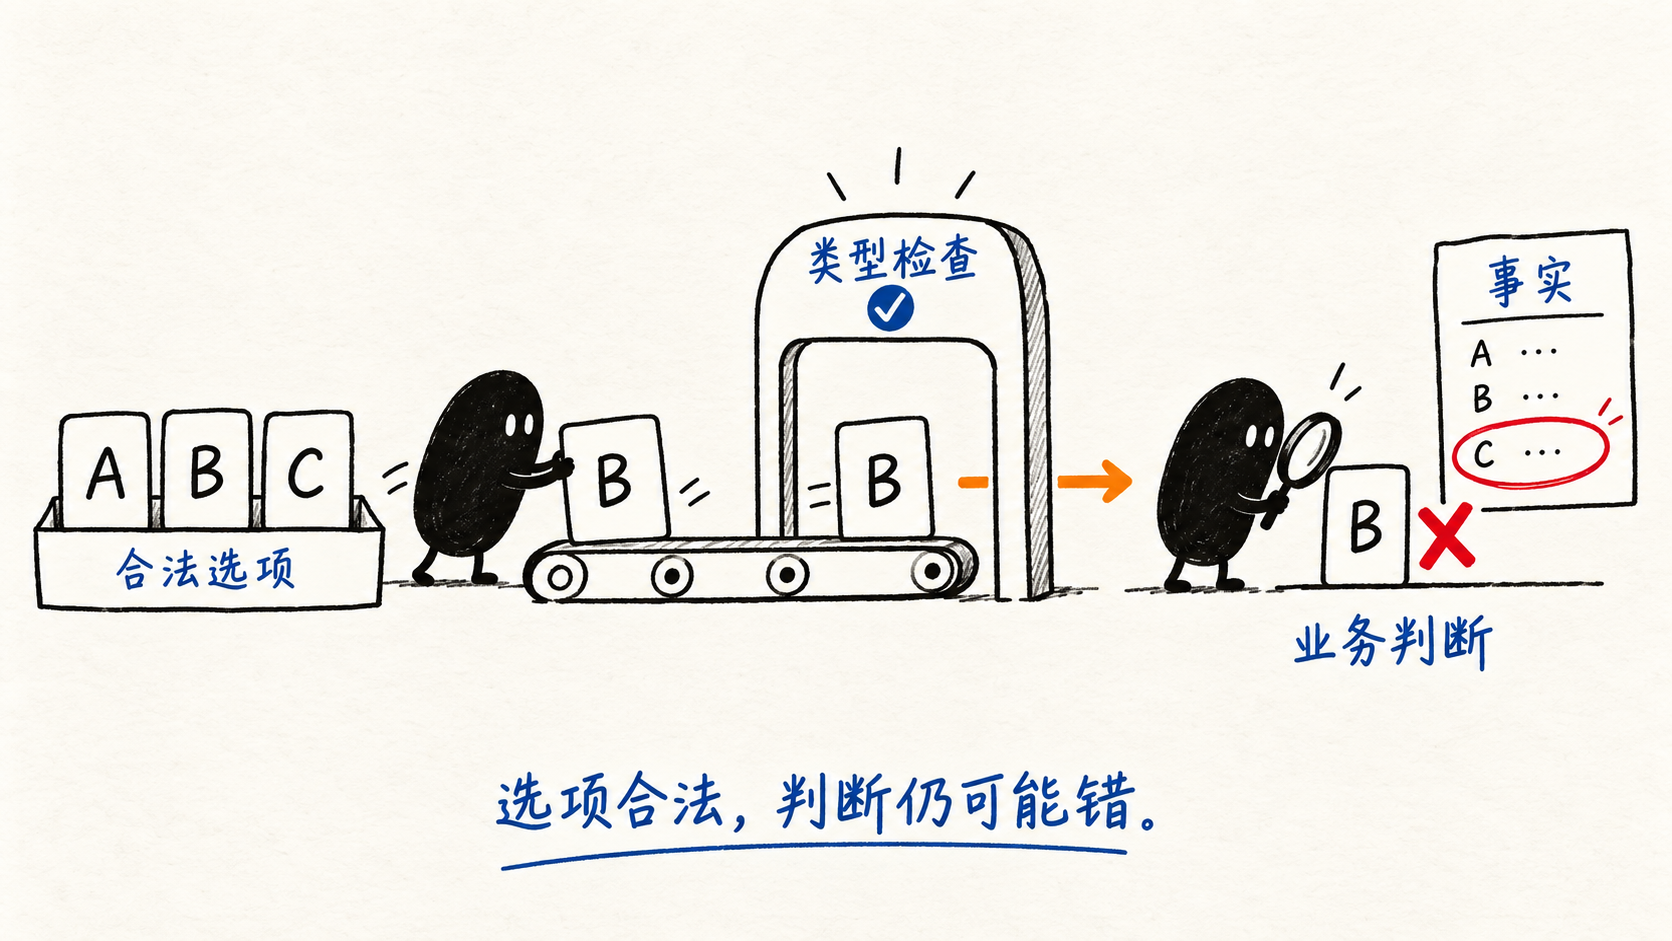
TypeSafe 对“无幻觉”的说明,把 schema 匹配保证作为重要依据。工程上应将这个保证理解为输出结构和取值约束,不能扩大成“业务判断不会错”。即使返回值合法,权限、状态前置条件和实际执行结果仍属于调用方要检查的内容。类型安全说明
概率还多一层要求。softmax 可以把一组数变成总和为 1 的分布,却不会自动让 0.9 变成“有九成把握正确”。校准良好的直观含义是:在一组报出约 90% 置信度的预测中,实际正确比例也接近 90%。这是一种统计性质,不能用单个样本检验。On Calibration of Modern Neural Networks
jevlike 输出选项概率,并报告 ECE 等评估指标;报告一个校准指标,不等于已经获得良好的校准。TypeSafe 将 RLCD 作为自己的训练方法介绍,也不能据此推断 jevlike 具有同样的概率质量。
对自动化系统而言,阈值应来自实际数据和错误成本。例如分流到人工复核,可以观察提高阈值后自动处理覆盖率下降多少、错误率降低多少。任意写下一个 0.95,并不能赋予系统可靠性。
还要检查菜单本身。如果所有候选都不适合当前输入,softmax 依然会分配完全部概率,并选出一个最高项。需要拒答或澄清的业务,应在任务设计中考虑这种情况,并通过数据检验;在菜单里增加“其他”只是提供了表达出口。
把开放推理与受约束决策分开
直接优化正确选项,训练目标与分类、路由任务更接近,这是尝试评分模型的理由。但目标更贴近任务,不足以推出它一定更准。编码器能否理解状态、训练数据是否覆盖目标场景、候选是否完整,都会影响结果。
“如何优化 PostgreSQL 查询”需要分析并提出方案,输出空间是开放的。若已经获得执行计划、约束条件和几个待评估方案,下一步可以变成受约束的比较。但候选由谁提出、状态是否充分、选择后如何验证,仍然需要系统设计。
这给 Agent 提供了一种可尝试的职责划分:开放式模型负责探索和提出方案,评分模型处理定义清楚的局部判断,代码负责组合条件和执行操作。它是一种架构选择,不是要求每个系统都增加三层模型。
甚至不一定需要引入新模型。如果现有规则已经足够准确,规则就是合适的实现;如果固定分类器满足质量和延迟要求,也没有必要仅为了动态选项更换它。只有当选项会变化、状态需要语义理解,并且决策调用的成本确实成为问题时,这类接口才值得认真评估。
Jev 与 jevlike 带来的启发,落在一个具体的设计问题上:程序下一步需要消费什么,模型就应尽量直接输出什么。 需要解释和创造时,保留语言生成;只需要在已知选项中判断时,先考虑能否直接计算决策。
延伸阅读
- TypeSafe:Introducing System One Models & Jev,产品定位、官方性能结果与评估限制。
- TypeSafe 文档,Choice、Score、Noul 及代码组合方式。
- jevlike 源码,本文核对的固定版本。
- On Calibration of Modern Neural Networks,概率校准的定义、测量与方法。
- 本文起点:关于 Jev 与 jevlike 的分享对话。产品与代码事实以上述一手资料为准。