2026 年 6 月中旬,Movez 在 X 上那条 Kimi K2.6 swarm 的推文刷到接近一百万次浏览。标题写得很冲:《The Self-Improving Loop: a 300-agent swarm on Kimi K2.6, verified by Opus 4.8》。它讲的版本大概是:一个免费的开源模型,用单个 prompt 拉起 300 个并行 agent、跑 4000 步,在真实研究任务上超过贵它 5 倍的闭源旗舰。
我卡住的是标题里的两个词:“self-improving”(自我进化)和 “verified by Opus 4.8”(由 Opus 4.8 验证)。前一个词说它能自己变强,后一个词又承认它需要另一个模型来验货。这两个词放在一起,反而把边界露出来了:执行可以被装进模型,判断不能。K2.6 的 swarm 确实是开源侧的一次进步;但我更想看的不是“谁赢了 benchmark”,而是当模型开始自己编排自己时,到底哪部分在进化,哪部分还必须留在模型外面。
先看这张饼:开源、便宜,还说会进化
先把 Movez 卖的东西摊开看。Kimi K2.6 是 Moonshot AI 在 2026 年 4 月 20 日放出的开源模型,1 万亿参数的 Mixture-of-Experts、激活 32B、256K 上下文,Modified MIT 协议,权重挂在 HuggingFace 上。价格是 $0.95 / 百万 input、$4.00 / 百万 output,大概是 Opus、GPT 这代旗舰的 1/5 到 1/6。便宜到能让人忽略它所有的不足。
它最吸引人的功能叫 Agent Swarm:模型自己当编排者(官方的说法是 adaptive coordinator),把一个复杂任务拆成异构子任务,派给最多 300 个并行 sub-agent,跨 4000 步协调执行。一次 API 调用进去,一份完整产出(文档、网站、幻灯片、表格)出来。相对上一代 K2.5 的 100 个 agent、1500 步,这组数字确实涨了一大截。Moonshot 自己的描述也很有画面感:coordinator 会根据每个 agent 的技能画像派活;某个 sub-agent 卡住或失败,它会检测到、重新分派、甚至重新生成子任务,再把各路输出合并交付。
Movez 把这套东西包装成"自我进化的循环",意思是:不只是更猛,是会自己变猛。这个说法很好卖——开源、便宜、还能自己进化,几乎集齐了 2026 年最容易转发的三个词。一百万次浏览,多半是冲着这几个词来的。
分数好看,但赛道也挑得准
分数要拆开看。
把 HuggingFace 上 K2.6 的模型卡拉出来,逐条对 benchmark,会发现一个规律:K2.6 最占便宜的,几乎全是 swarm 模式专属的赛道。BrowseComp 的 Agent Swarm 模式,K2.6 拿到 86.3,GPT-5.4 只有 78.4,差出近 8 分;DeepSearchQA 的 F1,K2.6 是 92.5,GPT-5.4 是 78.6、Opus 4.6 是 91.3。这两个 benchmark 测的是"能不能并行铺开大量 agent 做广度搜索和深度研究"——恰好是 swarm 架构的主场,也恰好是闭源旗舰没有对等模式可跑的赛道。
但切到单 agent 的硬任务上,结果就没那么漂亮了。
| benchmark | K2.6 | 对比项 | 结果 |
|---|---|---|---|
| BrowseComp (Agent Swarm) | 86.3 | GPT-5.4: 78.4 | K2.6 大幅领先(swarm 主场) |
| DeepSearchQA (F1) | 92.5 | Opus 4.6: 91.3 / GPT-5.4: 78.6 | K2.6 领先(swarm 主场) |
| SWE-Bench Verified | 80.2 | Opus 4.6: 80.8 | 打平,略输 |
| SWE-Bench Pro | 58.6 | Opus 4.7: 64.3 | Opus 领先 5.7 分 |
| APEX-Agents | 27.9 | GPT-5.4: 33.3 | 闭源领先一大截 |
SWE-Bench Verified,K2.6 是 80.2,Opus 4.6 是 80.8——基本打平,K2.6 还略低。SWE-Bench Pro(更长链路、更大仓库的工程任务),K2.6 是 58.6,Claude Opus 4.7 已经到 64.3,差 5.7 分。APEX-Agents 这种纯 agentic 多步任务,K2.6 是 27.9,GPT-5.4 和 Opus 4.6 都在 33 上下。Toolathlon、MCPMark 这些工具调用类项目,K2.6 同样不占优。
我更愿意把它读成下面这张拓扑图:只要任务可以被拆成大量浅层、相互弱依赖的检索和合成单元,swarm 的吞吐优势就会放大;一旦任务要求单个执行链持续保持上下文、跨工具做深层判断,优势就会回落。
flowchart LR
    T["任务类型"] --> W["广度研究
检索 / 合成 / 对比"]
    T --> D["深链工程
仓库理解 / 工具调用 / 修复"]
    W --> S["swarm 主场
大量浅层并行"]
    D --> E["executor 主场
长上下文持续判断"]
    S --> K["K2.6 优势被放大"]
    E --> C["闭源旗舰仍占优或打平"]

    classDef task fill:#f8fafc,stroke:#64748b,color:#1f2933;
    classDef swarm fill:#eef7f6,stroke:#2b7a78,color:#1f2933;
    classDef deep fill:#f2f4ff,stroke:#4c51bf,color:#1f2933;
    class T task;
    class W,S,K swarm;
    class D,E,C deep;
所以"超过贵 5 倍的模型"这句,成立的前提是任务正好落在 swarm 的主场。一旦任务要的是单 agent 深度推理或多步工具调用,K2.6 的价格优势还在,但"超过"就不成立了——它是用更便宜的 token 换一个略低或明显更低的质量。这不丢人,开源模型做到这一步已经很强,但它和 Movez 卖的"自我进化、全面超越"不是一回事。
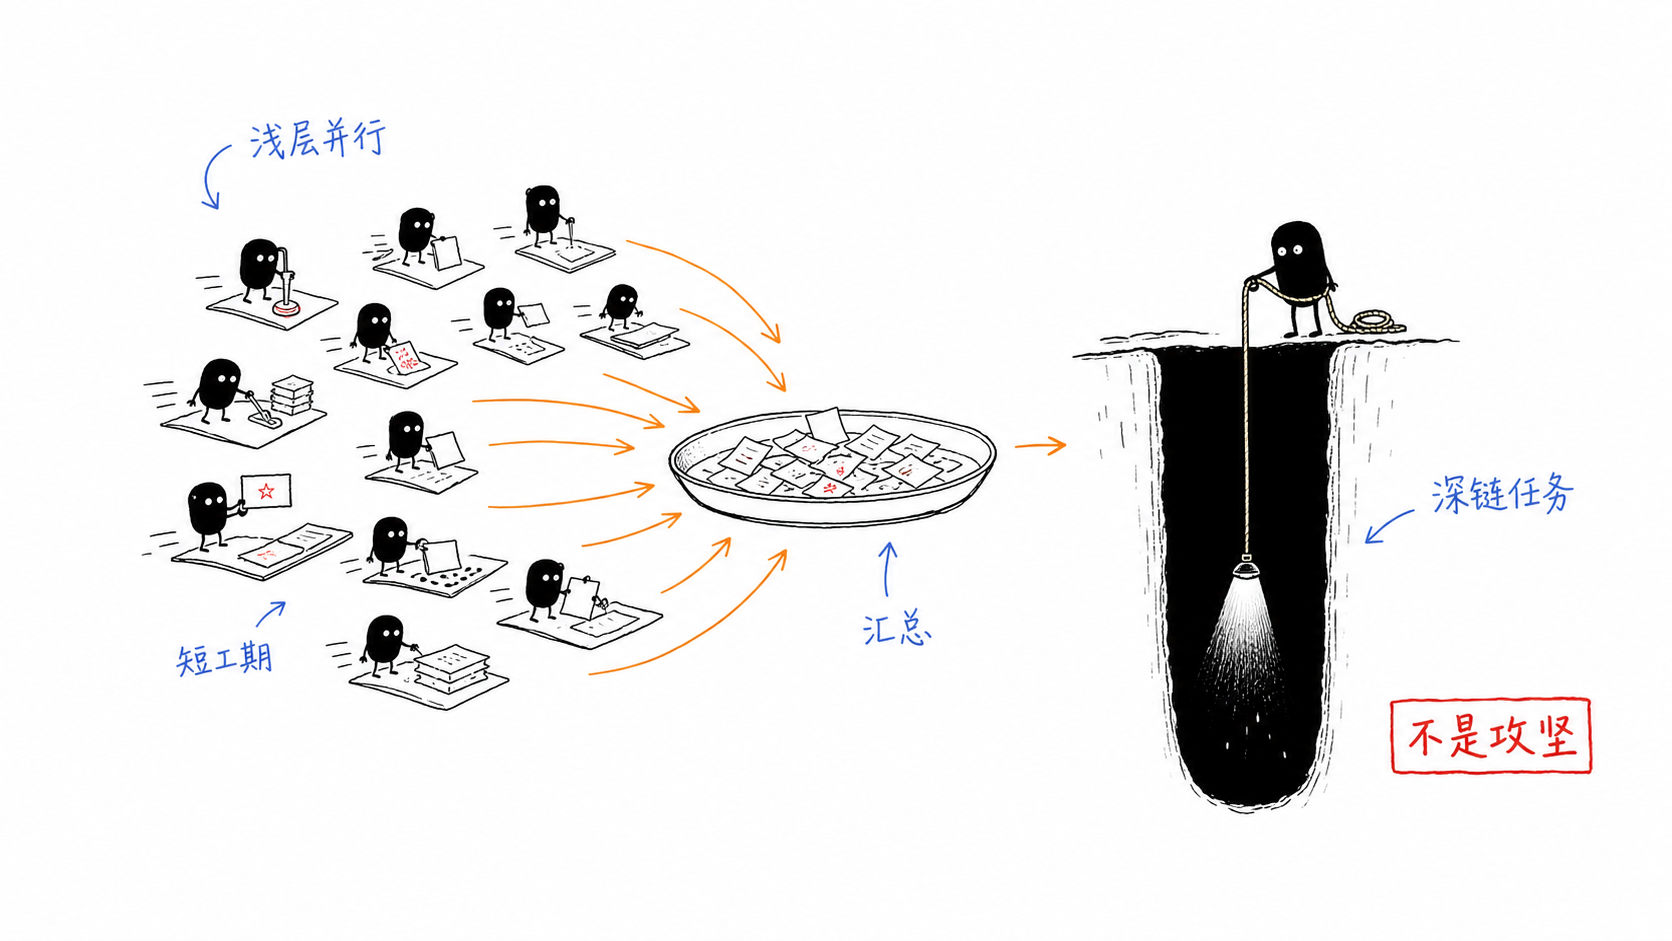
还有个容易被标题唬住的数字:4000 步。它不是每个 agent 跑 4000 步,是整个 swarm 一共 4000 步的总预算。300 个 agent 分下来,平均每个才 13 步左右。这意味着 swarm 擅长的是大量浅层、专门化的子任务并行,不是 300 个深度推理 agent 同时攻坚。把它想象成"300 个短工期工人"而不是"300 个资深工程师",更接近真相。
先把「self-improving」拆开
benchmark 选主场,还只是宣传层面的小账。更大的问题,是 Movez 标题里那个最唬人的词——self-improving——从根上就站不住。
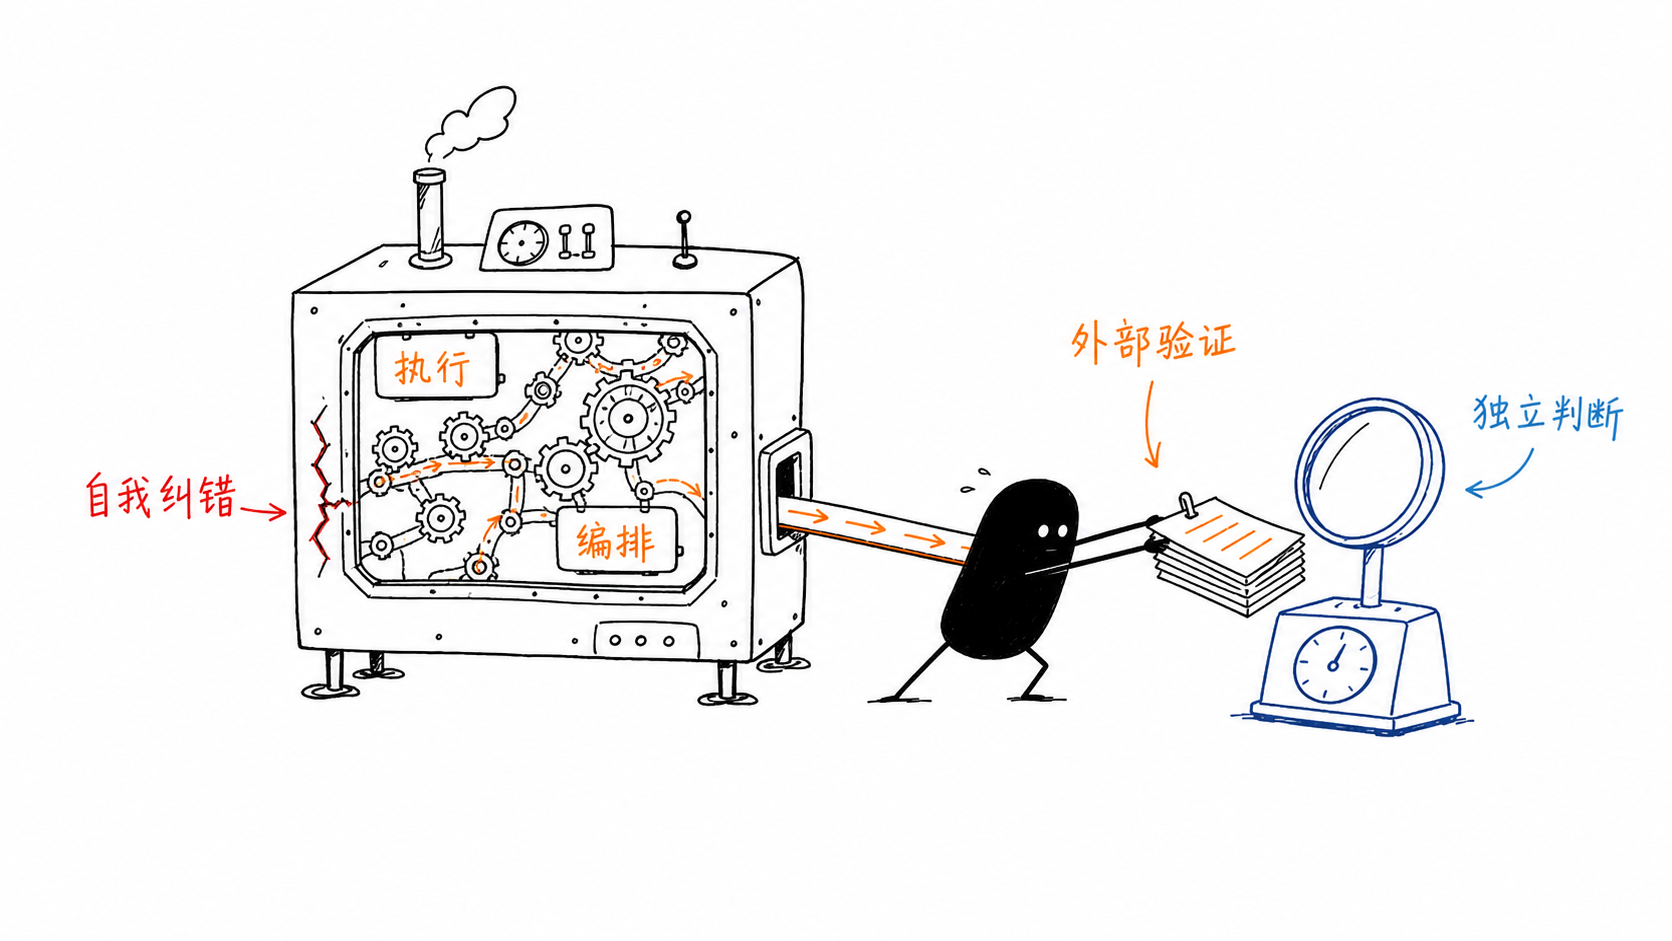
“自我进化"在机器学习里有明确含义:系统会更新自己的参数,或者至少积累持久的能力,下一次比这一次强。K2.6 的 swarm 是在变强吗?没有。一次 run 里模型权重纹丝不动;所谓"循环”,是 coordinator 发现某个 sub-agent 卡住或失败后,重新派发任务、重新生成子任务,最后把各路输出合并。这是一个 self-correcting 的调度纠错循环,不是 self-improving。把"会自己补救"偷换成"会自己变强",是这词最大的水分。
转折点不在词义辨析,而在 Movez 自己标题的后半句:verified by Opus 4.8。
把这句话和前半句放一起看,矛盾就出来了。前半句宣称,300 个 agent 的编排、协调、纠错全在 K2.6 这一个模型内部完成——这是"自我进化"叙事的根基,编排被装进了模型。可后半句立刻说,最终要靠 Opus 4.8 来验证。如果 K2.6 内部的编排真的足够,为什么还得外挂一个完全不同厂商、贵好几倍的模型来兜底?
flowchart TB
    subgraph inside["K2.6 模型内部(执行 + 编排)"]
        direction TB
        O["adaptive coordinator
分解 / 分派 / 失败重派"]
        A["300 sub-agents 并行执行"]
        O --> A
    end
    A -- "合并产出" --> Gap{"模型内有独立的
判断层吗?"}
    Gap -. "没有。执行能内化,
判断不能。" .-> V["Opus 4.8 外挂 verifier"]
    V -- "honesty / faithful reporting" --> Done["可信交付"]
    classDef inside fill:#eef7f6,stroke:#2b7a78,color:#1f2933;
    classDef missing fill:#fdecec,stroke:#b03a3a,color:#1f2933;
    classDef ext fill:#f2f4ff,stroke:#4c51bf,color:#1f2933;
    class O,A inside;
    class Gap missing;
    class V,Done ext;
这说明:执行和编排可以塞进一个模型,独立的判断不行。300 个 agent 并行跑出来的东西,需要一个不参与执行、只负责挑错的 verifier 来兜底;而 K2.6 自己既当运动员又当裁判,靠不住。Movez 无意中用标题的后半句,推翻了前半句的叙事——这不是 self-improving loop,是一个 executor 外加一个独立 verifier。
Opus 4.8 被选中当这个 verifier 也不是偶然。它相对前代最被强调的改进叫 “honesty”:官方说法是它比前代少大约 4 倍的概率,放任自己写的代码里的缺陷蒙混过关。在一个会真的去改代码库、真的去执行任务的 agent 系统里,“虚假的确定性"才是最贵的失败模式——它把错误包装成自信,让你在很晚才发现问题。Opus 4.8 的价值不在它更聪明,在它更愿意承认"这里有问题”。这正是 executor 不该具备、verifier 必须具备的特质。
两条路线最后撞到同一条边界
Movez 标题的自相矛盾,比争"哪家模型强"更有用:agent 系统的稳定性来自执行和判断的分离,而不是模型本身有多强。有意思的是,2026 年两条看起来方向相反的路线,最后撞到同一条边界。
K2.6 选的是把编排做进模型。好处是零基础设施——一次 API 调用进去,一份合并产出出来,开发者不用自己搭 orchestrator。代价也被很多人点破:Daniel Braz 在拆解时直接写,这是 “zero infrastructure overhead, zero ability to audit or customize"。编排逻辑藏在模型里,你既看不见 300 个 agent 之间怎么互相依赖,也没法在某个子任务失败时插手纠正,coordinator 的失败模式没有任何文档。执行省事,治理交白卷。
另一条路线是 Claude Code 这一年走的。我前阵子写过它怎么从一个 CLI 工具长成 agent runtime:它把 orchestrator、权限、副作用治理、计划审批、验证、记忆全部外化成 harness 层的运行时保证,而不是塞进模型 prompt。最让我在意的是 2026 年中加进去的那句约束——
Report outcomes faithfully: if tests fail, say so with the output.
对会真的改代码的执行系统来说,“别制造假确定性"是信任的地基。它的验证也不是靠"换个更强模型”,而是写在 Workflow 里的对抗式子代理:一个 agent 干活,另一个专门挑漏,loop 直到挑不出问题。委派、并发、失败恢复、最终验证,被一颗一颗螺丝拧进了工具协议,而不是交给某个模型的自觉。
这两条路线看起来一个内一个外,但落到"执行和判断怎么分工"上是同一件事。K2.6 把执行和编排内化,发现判断兜不住,于是 Movez 外挂 Opus 4.8——分离发生在模型边界之外。Claude Code 从一开始就把判断(对抗验证、faithful reporting、计划审批)做成 harness 里独立的一层——分离发生在 harness 内部。两条路都承认了同一件事:执行和判断不能是同一个东西。区别只是这条边界划在模型里,还是划在 harness 里。
flowchart TB
    subgraph K["K2.6 swarm 路线:模型内吞执行"]
        direction TB
        K1["单次 API 调用"]
        K2["模型内 coordinator"]
        K3["sub-agents 并行"]
        K1 --> K2 --> K3
    end

    subgraph C["Claude Code 路线:harness 外化治理"]
        direction TB
        C1["主循环"]
        C2["权限 / 计划 / 沙箱"]
        C3["Workflow / 子代理"]
        C4["验证 / 记忆"]
        C1 --> C2 --> C3 --> C4
    end

    K3 -. "产出后再找裁判" .-> V["外部 verifier"]
    C4 -. "治理层内置裁判" .-> V
    V --> B["同一个边界:
执行 != 判断"]

    classDef model fill:#eef7f6,stroke:#2b7a78,color:#1f2933;
    classDef harness fill:#f2f4ff,stroke:#4c51bf,color:#1f2933;
    classDef verify fill:#fff4df,stroke:#b7791f,color:#1f2933;
    class K1,K2,K3 model;
    class C1,C2,C3,C4 harness;
    class V,B verify;
这张图比“内化 vs 外化”更接近工程实质:两边都需要 verifier,只是 K2.6 方案把 verifier 放在模型外另接一颗贵模型,Claude Code 方案把 verifier 做成 runtime 里的治理环节。可维护性差别也在这里——前者省基础设施,但边界不可审计;后者多一层 harness,但判断路径能被记录、复盘和替换。
我自己在做 agent 系统时的体感和这一致。手上一套宠物问诊、一套小说工具,我没把精力花在"换更强的底座模型"上,而是给每套都配了一个反方:漏了什么、证据够不够、有没有把假设当成事实。底座模型再强也会漏,会把自己的猜测当结论塞给你;一个独立 verifier 的长期收益,远高于把模型再换大一档。Claude Code 用一年 runtime 化走到了这里,Movez 用 Kimi 加 Opus 从另一个方向撞到了同一堵墙。
模型越自主,规则越比 prompt 值钱
执行和判断要分离,只是这个变化的一小块:当模型越来越自主,重点已经不在"写好一个 prompt"上,而在"设计规则、迭代路径和验证结构"上。
判断的依据不在别处,就在 Anthropic 自己的动作里。2026 年它干了一件让圈外人发笑、圈内人发毛的事:招了一位哲学博士出身的 Amanda Askell 常驻公司,专门负责给 Claude 写"人格"和"宪法”——一份两万多字的行为规则,定义 Claude 该怎么推理、怎么拒绝、怎么承认不确定。这还不够,它又把硅谷一位前科技高管转行的天主教神父 Father Brendan McGuire、梵蒂冈的 Bishop Tighe、还有几位伦理学者请进来,一起打磨这套规则。外网戏称 Anthropic 在"招神父给 AI 上道德课"。
精确地说,神父是被咨询的顾问,不是员工;真正入职的是 Askell 这样的哲学家和 character 设计者。但这个区分不影响重点。重点是伦理学者 Brian Patrick Green 转述的 Anthropic 的理由:公司意识到它——
can’t make a regulation about every single case
所以不再去写穷举式的禁令清单,而是塑造一个 disposition——一种面对没见过的新情况时,倾向于好好表现的稳定倾向。
这句话翻译过来,就是别再给每种情况补一条 prompt。那种东西半衰期太短,穷举不完,最后只会变成补丁堆。该写的是一套能反复用、能处理新情况的规则底座。Askell 写的那两万字不是一条 prompt,是一个 constitution——它管的是 Claude 在数百万次对话里稳定表现出的行为倾向,而不是把某一次问答调到最优。单条 prompt 是消耗品,规则层才是资产;模型每半年翻一倍能力,但 executor/verifier 分离、faithful reporting、对抗式验证、分层治理这些判断,是用很多年的工程审美换来的,不会随某家厂商发新版而失效。
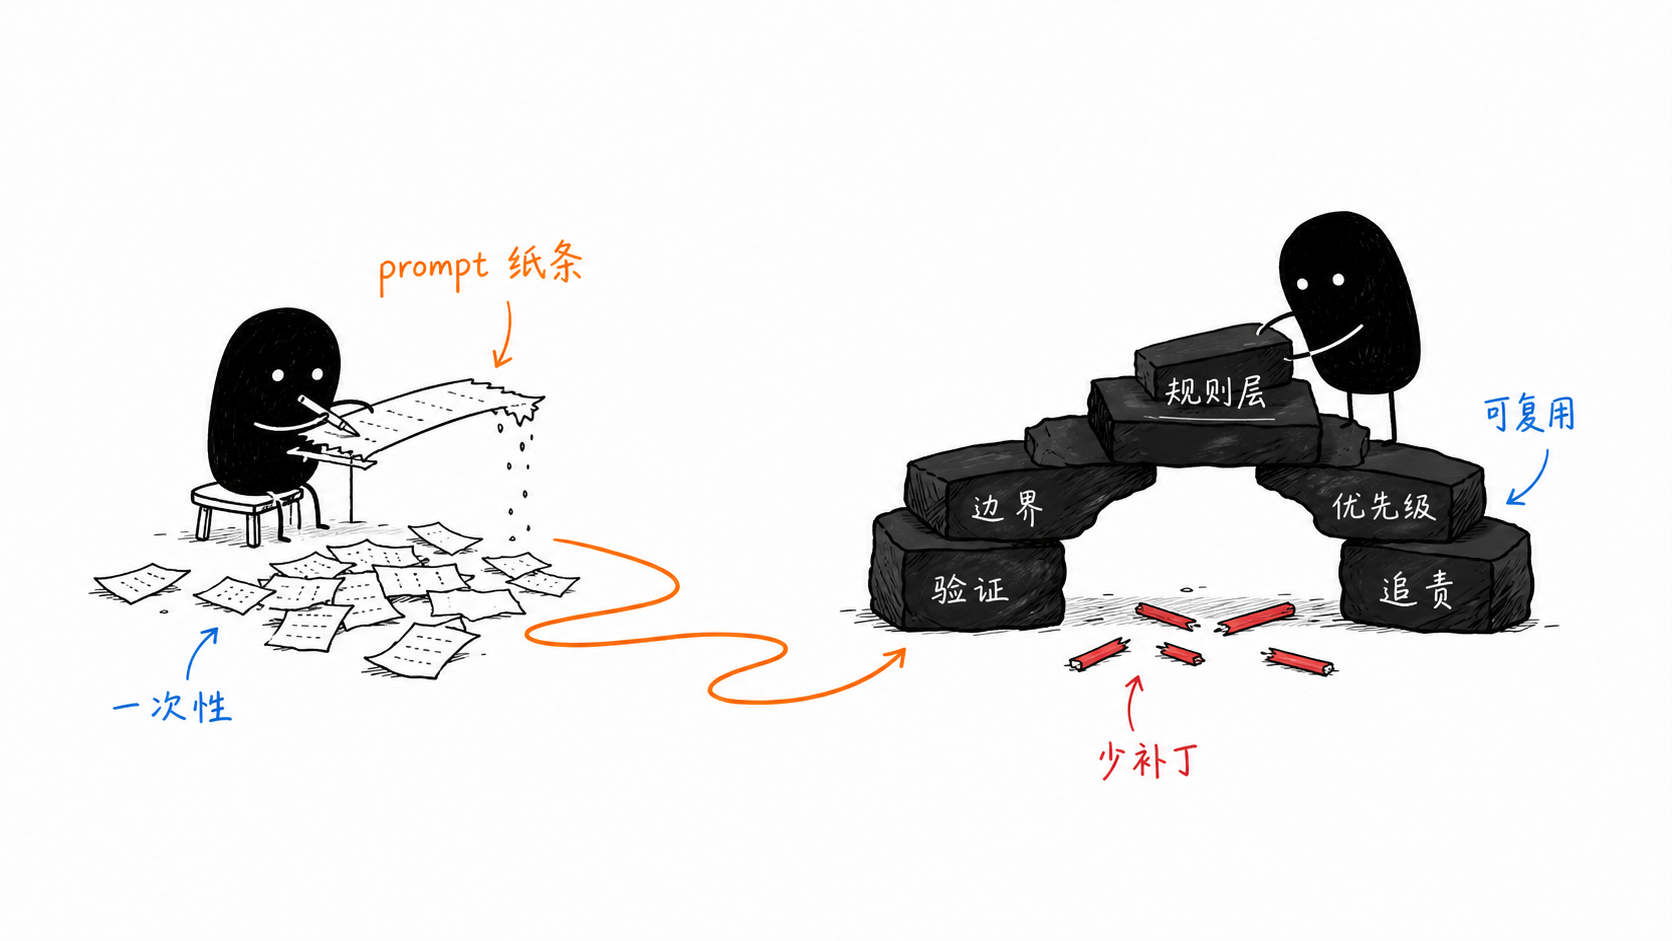
Movez 把 K2.6 的 swarm 叫 self-improving loop,误读了正在发生的事。自我进化的不是模型权重,而是围绕模型的那层做事方式:规则怎么定、验证怎么做、迭代路径怎么走。在一个模型越来越能自己跑起来的时代,精力该往哪里放已经很明显:别再雕那个 prompt 了,去写你的 constitution。
延伸阅读
- Movez 原推文:The Self-Improving Loop
- Kimi K2.6 官方技术博客 — Moonshot AI
- Kimi K2.6 模型卡(完整 benchmark 表)— HuggingFace
- Kimi Agent Swarm:成本与可审计性分析 — Daniel Braz
- 300 sub-agents 与 4000 步预算的澄清 — Verdent
- Widening the conversation on frontier AI — Anthropic
- The Catholic Priest Who Helped Write Anthropic’s AI Ethics Code — Observer
- Claude Code 如何长成 Agent Runtime(本站姊妹篇)